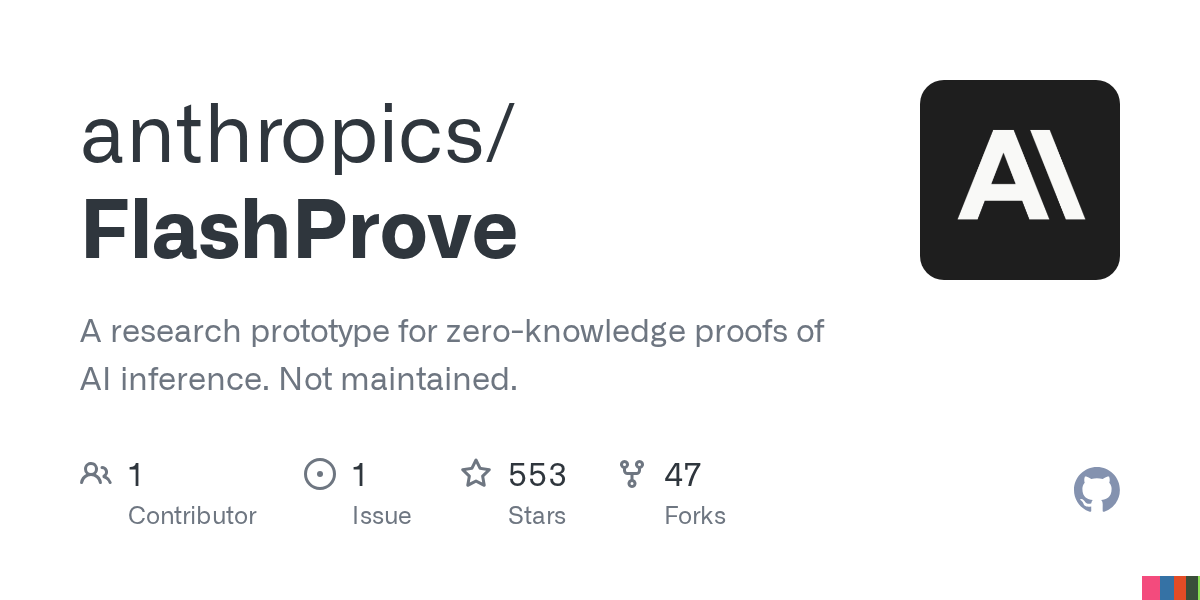
Поставщик заявляет, что работает с определённой моделью искусственного интеллекта: как клиент может это проверить? 2 ноября Anthropic опубликовала FlashProve, прототип с открытым исходным кодом, который генерирует криптографическое доказательство того, что ответ был произведён конкретной моделью, не раскрывая её весов. Демонстрация выполнена на Llama 4 Maverick в версии с 4-битным квантованием, на окнах в 1 024 токена. Это не активный сервис в API Claude, а код объявлен неподдерживаемым.
Мы изучили исследовательский пост Anthropic, подписанный сотрудниками компании совместно с учёными из EPFL и MIT, а также README публичного репозитория на GitHub. Пост на X, которым Anthropic анонсировала работу 3 ноября, не открывается нашими инструментами. Данные о производительности, которые мы приводим, заявлены Anthropic и не были независимо проверены третьими сторонами.
New Anthropic research: progress on provable inference for large language models.
, Anthropic (@AnthropicAI) November 3, 2026
Here, we introduce FlashProve. Building on established cryptographic techniques, FlashProve allows developers to verify whether a given response came from a given AI model. It's substantially more…
Проблема: кто на самом деле отвечал
Согласно Anthropic, сегодня пользователи не могут убедиться, что ответы поступают от той модели, которую декларирует разработчик. В посте обозначены два риска. Первый: сервисы маршрутизации могут подменять заявленную модель более дешёвой. Второй: атаки, изменяющие поток токенов между моделью и пользователем. Для тех, кто покупает ИИ через платформы-посредники, вопрос вполне конкретный: платишь за одну модель, а проверить, какая реально работает, невозможно.
Проблема обостряется по мере умножения каналов дистрибуции: от облачных платформ, перепродающих сторонние модели, как в случае выхода OpenAI в Google Cloud, до моделей с открытыми весами, предлагаемых разными поставщиками по разным ценам, как MiniMax с версией Flash.
Как это работает: обязательство, доказательство, верификация
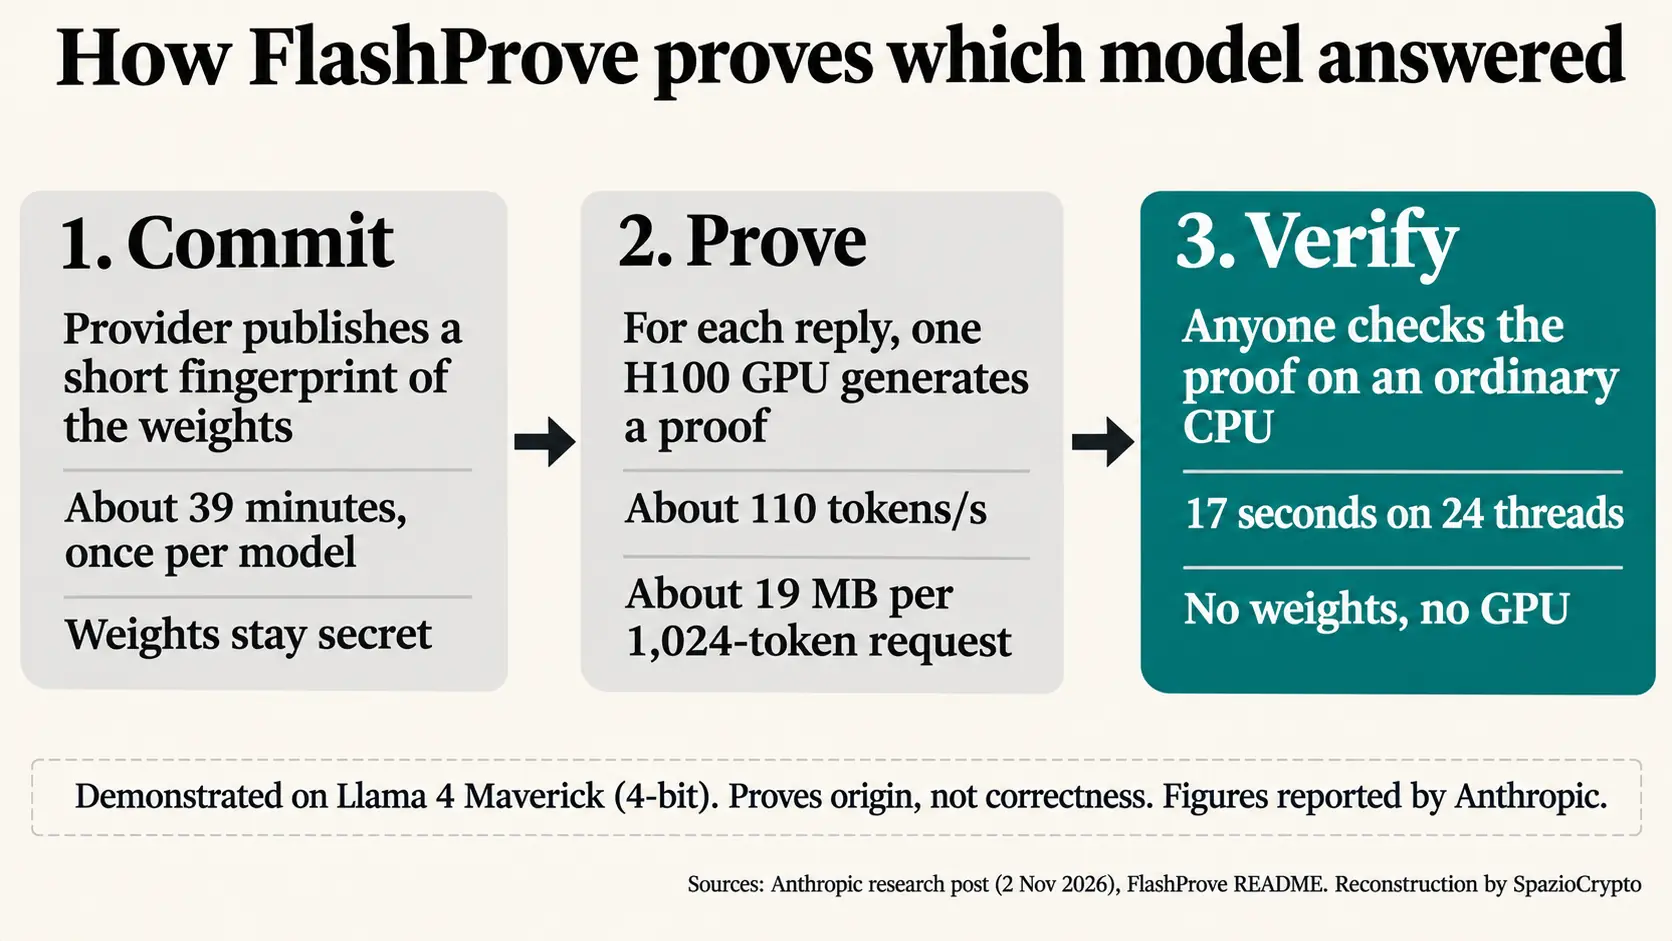
Система работает в три этапа. Сначала поставщик публикует краткий отпечаток, привязывающий его к точному набору весов без их раскрытия: по данным Anthropic, этот этап занимает около 39 минут и выполняется один раз для каждой модели. Затем для каждого ответа GPU поставщика генерирует доказательство того, что данная последовательность токенов является выходом зафиксированной модели. Наконец, любой желающий может проверить доказательство на обычном процессоре, без весов и GPU, имея только отпечаток, промпт и ответ.
Используемая техника называется zkSNARK: это доказательство с нулевым разглашением, подтверждающее правильность вычисления без раскрытия использованных данных. Это та же семья инструментов, которую криптовалютная индустрия применяет для обеспечения конфиденциальности и масштабируемости, а Банк Италии изучал для совмещения приватности и контроля в цифровых платежах. Веса, промежуточные значения и выбор экспертов модели остаются скрытыми. Архитектура, уточняет Anthropic, не скрывается.
Цифры прототипа
Llama 4 Maverick, это модель с 400 миллиардами параметров и архитектурой смеси экспертов, из которых около 17 миллиардов активны на каждый токен. Прототип работает с публичной 4-битной версией. По данным Anthropic, на одной GPU H100 с 24 процессорными ядрами фаза генерации доказательств выдаёт около 110 токенов в секунду, а каждое доказательство для запроса в 1 024 токена занимает около 19 мегабайт. Верификация доказательства занимает 17 секунд на 24 потоках, а клиенту требуется загрузить около 6,5 мегабайта данных обязательства.
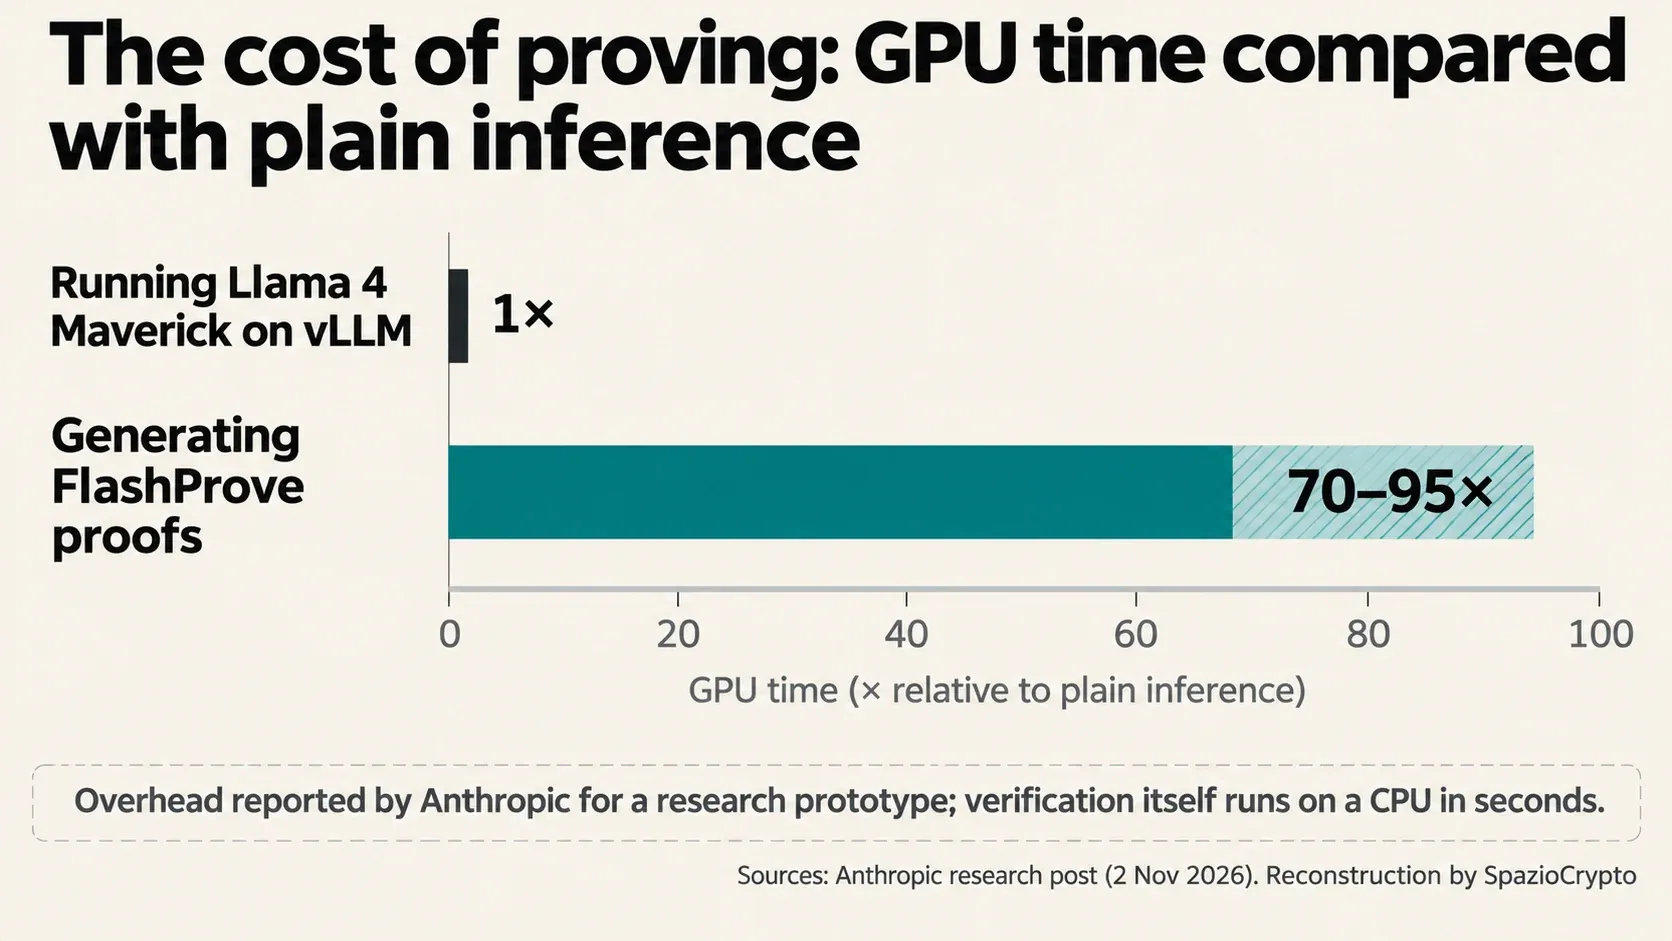
Главная проблема, стоимость. По данным поста, генерация доказательств требует от 70 до 95 раз больше времени GPU, чем запуск модели через vLLM, один из наиболее распространённых движков вывода. Anthropic сравнивает результат с другой работой, Attestable, которая достигает 53-77 токенов в секунду на плотной модели из 31 миллиарда параметров, однако не выпустила публичную библиотеку с открытым кодом.
Что доказательство не гарантирует
По сути, доказательство показывает, от какой модели получен ответ, но не подтверждает корректность самого ответа. Anthropic перечисляет и другие ограничения. Протокол рассчитан на детерминированное декодирование: при семплировании, которое вносит случайность в генерацию, реальный вывод может в какой-то момент отклониться. Верифицируемая модель представляет собой точную копию весов, а результат вычислений с плавающей точкой способен от неё отличаться. Квазиэквивалентность не охватывает специально сконструированные промпты, эксплуатирующие такие расхождения, а атаки по времени ответа находятся за пределами рассматриваемой модели угроз.
Есть и практические ограничения. Окно в 1 024 токена, по словам самой Anthropic, «довольно коротко» для полноценного диалога. Быстрый код на C++ не имеет формальных гарантий и не обязан точно соответствовать доказательству, записанному на языке Lean, где корректность протокола подтверждена математически. README репозитория однозначен: это исследовательский артефакт, «не поддерживаемый» и не принимающий сторонних вкладов. Внешних аудитов безопасности не упоминается.
 Anthropic
А что в России и СНГ?
Для компаний и государственных структур, закупающих услуги искусственного интеллекта через посредников или облачные платформы, FlashProve пока ничего не меняет: это не продукт и не интеграция в коммерческие сервисы. Тем не менее он задаёт направление. Контракт, обещающий конкретную модель, когда-нибудь можно будет верифицировать криптографическим доказательством, а не доверием поставщику. Именно такой путь прошли доказательства с нулевым разглашением в финансовых сервисах, где Coinbase добивается их признания в американских правилах по борьбе с отмыванием денег.
 Steve Weis
Тема затрагивает и технологическую зависимость от внешних поставщиков. Регуляторы фиксируют, что финансовый сектор ЕС зависит от иностранных систем ИИ, доступ к которым нередко осуществляется через несколько уровней посредников. Независимые от поставщика инструменты верификации могут стать обязательным условием контрактов по мере снижения затрат. Сегодня, при накладных расходах в 70-95 раз по сравнению со стандартным инференсом, это нереалистично для повседневного использования.
FlashProve: коротко о главном
Что подтверждено, а что нет
- Подтверждено: опубликован открытый прототип под лицензией Apache 2.0, релиз состоялся 2 ноября; протестирован на Llama 4 Maverick с квантизацией 4 бита при окне в 1 024 токена; верификация на CPU занимает 17 секунд без доступа к весам; накладные расходы составляют 70-95 крат от времени GPU при стандартном инференсе, согласно публикации Anthropic; код объявлен не поддерживаемым.
- Не указано: внешние аудиты безопасности; денежные затраты; применимость к API Claude или другим моделям; время верификации для длинных контекстов.
- За чем следить: расширение поддержки длинных контекстов и других архитектур; возможные интеграции со стороны поставщиков и платформ; независимые проверки кода.
Более широкий контекст
Наша интерпретация, которую мы открыто заявляем как таковую: FlashProve переносит в область искусственного интеллекта идею, рождённую в криптомире, не доверять, а проверять. Сегодня пользователь AI-сервиса вынужден верить поставщику на слово относительно того, какая модель используется, точно так же, как прежде приходилось доверять посреднику в вопросе остатка на счёте. Криптографическое доказательство разделяет два вопроса, которые нередко смешивают: откуда получен ответ и насколько он хорош. FlashProve отвечает только на первый, и это уже немало. Остаётся открытым вопрос, решит ли кто-то, включая саму Anthropic, внедрить его в реальные сервисы, как это происходит с другими инициативами в области прозрачности, например с доступом оценщиков METR внутри Anthropic.
Три сигнала заслуживают особого внимания. Первый: снижение вычислительных накладных расходов, сейчас составляющих, по данным Anthropic, от 70 до 95 крат, без чего ни один поставщик не сможет предлагать доказательства для каждого ответа. Второй: расширение поддержки длинных контекстов и других моделей, в том числе закрытых, таких как Claude. Третий: возьмут ли код, заброшенный авторами, другие исследовательские группы или платформы, заинтересованные в верифицируемом происхождении ответов модели.